用 Agent 团队帮我完成设计、开发和运营
我想分享一下我个人用 agent 管理开发的经验,也介绍一下 Cindy 的一些用法。
Agent 全程参与
我在做一个有桌面端和服务端的产品。从调研、设计、开发、测试,到发布和上线后的运营,现在每一步都有 agent 在做,29 天里光产品仓库就合了 902 个 MR。这么多活,我不可能一件件盯。我给自己的分工是只定方向、看证据、拍板,其余的都交给 agent。
能这样放手,靠的是四件事。完整的任务交给 agent,方向和取舍留给我自己,agent 交付时要带着证据,我按结果来管。重复的管理做成流程,琐事交给定时跑的 agent。犯过的错写回规则,每天自动复盘一次。这些我都在 Cindy 里做,Claude Code 和 Codex 的会话和记忆都在一处,语音输入、远程桌面、跨机器测试这些功能拿来就能用,不用自己拼。
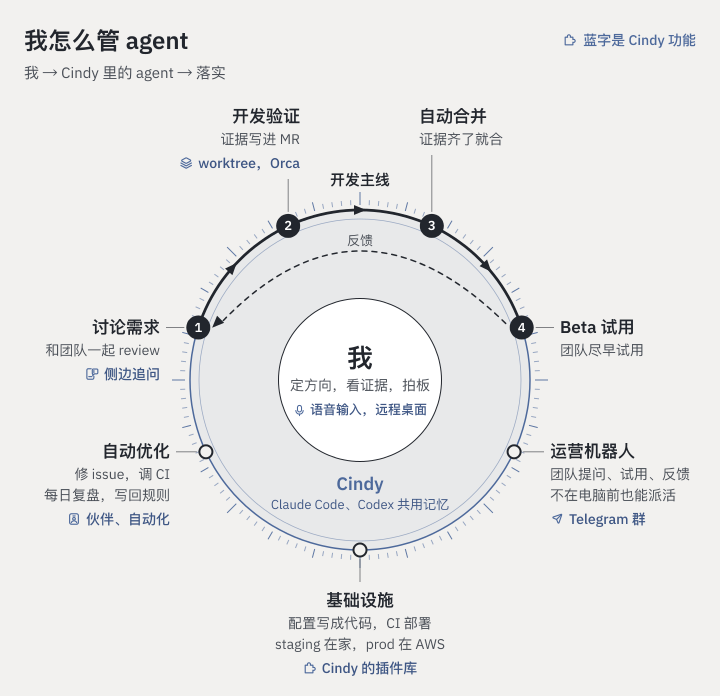
一张图看全文。我在中间,Cindy 里的 agent 围着我,落实的事挂在圈上,蓝字是用到的 Cindy 功能。
图上,我的决定交给 Cindy 里的 agent 去落实。落实的事里最重要的是开发主线,需求先和 agent 讨论清楚,agent 带着证据交付,证据齐了自动合并,再用 Beta 交给团队去试,反馈回来进入下一轮。主线之外,基础设施同样交给 agent 管,运营机器人在 Telegram 群里和团队打交道。琐事和每天的复盘交给定时跑的伙伴,复盘把教训写回规则,整套流程就越跑越顺。后面几节把图里的每一块展开讲,蓝字标的 Cindy 功能放到最后一起说。
开发主线
这是我的 AI native 开发流程,也就是开头那张图上方的四步,讨论需求、开发验证、自动合并和 Beta 试用,Beta 的反馈再回到下一轮讨论。写代码、开 MR、跑流水线,大家的做法都差不多,下面只说每一步里我花了心思的地方。
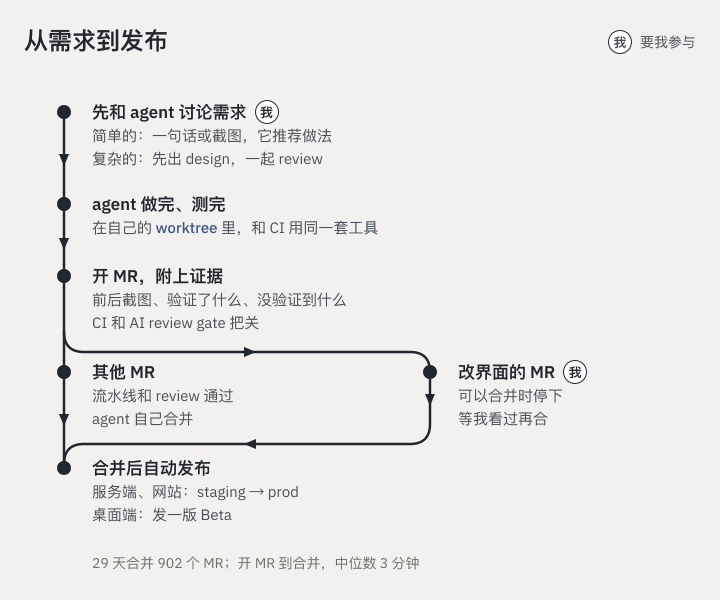
改界面的 MR 等我看过再合,其余的证据齐了就自动合。
讨论需求
每个需求,第一步都是先和 agent 讨论。简单的,一句话或者一张截图就够了,让它自己推荐做法。大的设计和交互改动不一样,方案得先和团队讨论清楚,再让 agent 动手。
我的做法是让 agent 把方案做成一个独立的 HTML 页面,放进 review 工具。我和团队直接在页面上选中文字,或者框出一块区域写批注,在评论区互相回复。agent 看了意见去改设计,改完在评论下面说明改了什么,我们再看新的一版。团队和 agent 一直在同一个 context 里讨论,谁也不用再解释自己说的是哪一块。
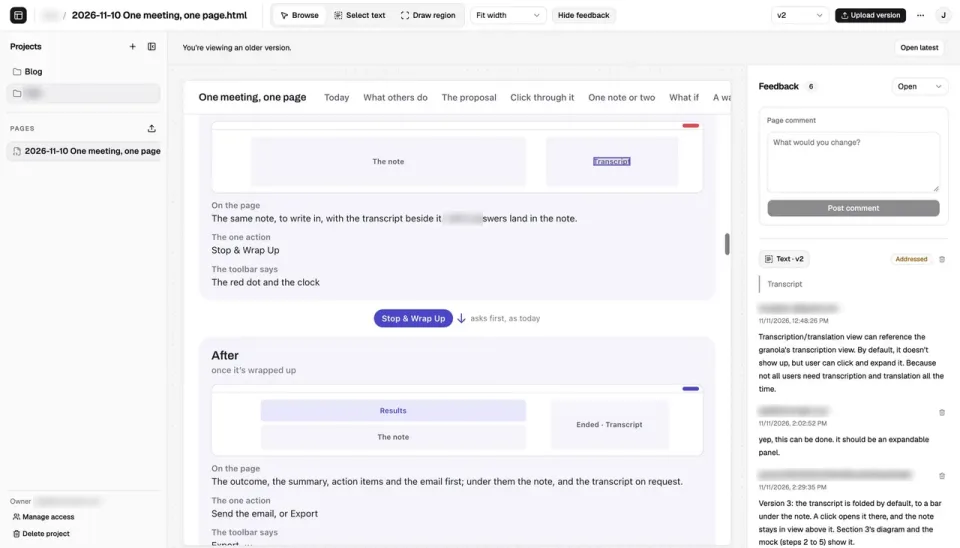
批注、讨论、改稿,都在同一个页面上。
支线
一个大任务做着做着,总会冒出一些相关、但不是一回事的问题。我的原则是不打断主线。要展开讨论的,分到侧边追问(side chat)里去聊,不急着做的就记成 issue 以后再说。
侧边追问是从当前会话分出去的,带着已有的上下文去查、去讨论,主线照常往下做。做一个大功能的时候,我前后开过十几个。
不急的问题就放进 GitLab work item。agent 干活时发现的 bug、可以改进的地方、后续要做的事,收尾前都会建成 issue,或者更新已有的。每个 issue 有一个状态标签,要我拍板的标“等我决定”,标了“可以做”的就交给 agent。这段时间产品仓库新建的 issue,已经关掉了 190 个。
开发验证和自动合并
需求定下来,agent 就去写代码、开 MR。我花心思最多的,是怎么判断它真的做对了。agent 平均一天合三十多个 MR,我不可能一个个看代码,只能看证据。所以我只管三件事,怎么验证,交什么证据,什么时候能合。
验证方式是统一的。agent 和 CI 用同一套命令行工具跑测试、截图、等流水线,本地怎么验,CI 上就怎么验。要在 Windows 或另一台 Mac 上验收,不用我安排,主会话会自己把测试派过去,结果自动回来。
证据写在 MR 里,包括改了什么、验证了哪些、哪些没验证到、有没有走捷径。改了界面,还要附上 main 和分支的前后截图。没验证到的部分最不能省。告警规则用真实日志回放过,不等于在 Telegram 里真的响过,这一点不写出来,我只会看到测试通过。
证据齐了、流水线通过、review bot 也批准了,agent 就自己合,只有改界面的 MR 要等我看一眼。那 902 个 MR 从开到合,中位数是 3 分钟。
这些规矩写在 AGENTS.md 里,大多是 agent 犯了错以后补的,差不多 30 天里改了 300 多次。比如 agent 为了复现一个偶发失败的测试,开了 24 个死循环压 CPU,负载冲到 40 多也没复现出来。现在规定只能在怀疑的那一步人为加延迟,还要先证明旧测试会失败、新测试能通过。又比如检查 prod,以前拿到 200 就算成功,结果检查是绿的,prod 其实在返回空页面,现在只认带 API 请求 ID 的回复。规则写进去一次,后面所有会话都照着做。
Beta 试用
新功能我希望尽早交到团队手里去试,不用等全部做完。办法是 feature flag 加上几种不同的版本。
功能没做完也可以合。没做完的部分藏在 flag 后面,拆成小 MR,每天合进去。flag 默认关着,只能在开发者设置里打开。
开发的时候用 debug 版。它默认连本机起的整套服务,也就是 local stack,用测试账号、demo 数据和假的 AI,所有 flag 都能打开。要换环境,改四个设置就行,连本地、staging 还是 prod,用测试账号还是 Google 登录,用 demo 数据还是真实数据,AI 用假的还是真的。所以同一个 debug 版也能连到家里的 staging,agent 用测试账号测,我想自己试,就用自己的 Google 账号登录。服务端和网站的改动合并以后,CI 先部署到 staging,过了端到端检查,再自动部署到 prod。
做到能试了,就交给团队用 Beta。Beta 和正式版可以装在同一台电脑上,数据、登录、更新通道和图标都是分开的。它连 prod、用真实账号,但只能打开标了 Beta 的 flag。每个改到 app 的 MR 合并、测试通过以后,CI 会自动发一版 Beta。app 每小时检查一次更新,更新说明就用这段时间合并的 MR 标题。多的时候一天发 30 版。
正式版不一样,什么时候发由我决定。正式版没有开发者设置,flag 碰不到它。要发版的时候,agent 开一个 MR 改版本号,用现成的 skill 根据上个版本以来的改动起草更新说明。合并、打 tag 以后,CI 负责构建、签名和 Apple 公证,先发到 staging 的更新通道,再发到 prod 的。
基础设施也交给 agent
前面这些流程能跑起来,靠的是背后的环境,家里的 homelab、开发机和 CI,还有 AWS 上的 prod。这些我也交给 agent 来管,做法和写产品一样,配置写成代码,改动走 MR。29 天里,基础设施仓库合了 134 个 MR。
都写成代码
agent 能管好基础设施,前提是所有东西都写成了代码。家里的基础设施都在一个 infra 仓库里,用 Ansible 和 OpenTofu 管理,里面有家庭服务、自建的 GitLab、共享的 Postgres、DNS 备份,还有 Mac 和 Windows 的开发和 CI 环境。专跑 coding agent 和 CI 的那台 Mac mini,就是 agent 写好 playbook 配出来的。之前写过一篇用 agent 重建 homelab,日常维护到现在还是那一套。
改基础设施和改产品一样,要开 MR,过 CI 和 AI review gate。大一点的改动要留工作记录,以后还用得上的做法写进运维文档,拓扑或服务有变化就更新 homelab 现状那篇笔记。这样换一个新会话来接手,看代码和文档就能接着干,不用我再讲一遍来龙去脉。
Local stack 高效,AWS 稳定
环境分两处放,各取所长。staging 跑在家里现成的机器上,省掉了不少云上的开销。prod 放在 AWS 上,按高可用来搭,每晚自动备份。两边各通过一条 Cloudflare Tunnel 对外,都由 CI 部署,AWS 和 Cloudflare 的配置同样写成了 OpenTofu 代码。prod 迁到 AWS 也很快,11 月 6 日开始做方案,7 日就切过去了。
prod 上线以后,最要紧的是出了问题能马上知道。指标和日志都收进了监控看板,出错就告警。告警规则是 agent 调的,用真实日志回放检查过,减少短暂错误造成的误报。每天早上还有一个任务看 app 的崩溃报告,发现问题就去调查,然后告诉我。
不过 infra 仓库的 MR 都是我来合。夜里自己跑的 agent 可以提修改、开 MR,但不能直接动正在运行的机器。
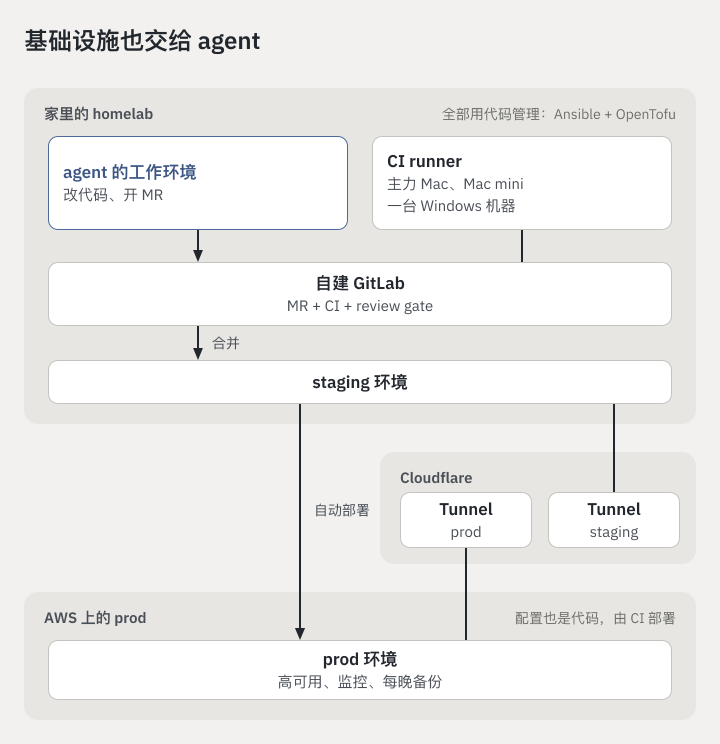
staging 在家,prod 在 AWS,配置写成代码,CI 来部署。
产品代码怎么组织
产品代码这边,所有东西都放在一个 monorepo 里,agent 一次就能看到整个产品。Mac 和 Windows 桌面端、服务端、网站、API 定义、部署配置、设计 mock 和工具都在里面,客户端的 API 代码从定义生成。
一个功能如果同时要改 app、服务端和 API,在一个 MR 里就能改完、测完,不用在几个仓库之间对齐版本。整个仓库只有一份 AGENTS.md、一个命令行入口、一条 CI,前面说的规则和验证方式,所有改动都一样适用。
运营机器人和 Telegram 群
我和团队跟 agent 打交道,除了在电脑上,很多时候是在 Telegram 群里。团队可以直接在群里问 agent,比如最新的下载链接在哪。我不在电脑前,也在群里派活,遇到要我批准的步骤,回一句它就接着做。
新功能的反馈也在群里转起来。每个功能做完,MR 描述里要写一段公告,等部署和 Beta 都发完,CI 自动把它发到群里的新功能话题。团队在 Beta 里打开 flag 试,有问题就在群里说,我转给 agent 去改,改完下一版 Beta 又自动发出来。
查数据也不用找我。群里有一个运营机器人,/kpi 看关键指标,/cost 看一场会议花了多少 AI 成本。/cost 本来是我自己要查的,问了两次以后,干脆让 agent 做成了大家都能用的命令。它开发、验证完,停在上线要批准的那一步,等我回了一句才继续。
prod 的告警发到群里的运维话题。我自己还有一个群,收 homelab 的维护通知和每晚的资讯摘要。
自动优化
除了主线的开发,每天还有一堆小事,扫一遍待办,看看崩溃报告,查查 CI 哪里又变慢了。这些事放着不管不行,可要是每天都得我想起来、派下去、再追结果,注意力就全被它们占了。
所以我把这些事交给固定的角色,Cindy 里叫伙伴(Teammate)。每个伙伴有自己的工作目录和记忆,具体怎么做写在一个 playbook 文件里,到点由自动化叫起来。我前后建了 5 个,现在 3 个在跑。
负责修复的伙伴每 6 小时扫一遍 GitLab work item,从标着可以做的 issue 里挑容易的修。从 11 月 3 日到现在,它跑了 73 轮,经手了 76 个 MR,其中一次查清了让 Beta 两次卡在旧版本的竞态问题。遇到产品上的取舍,它把选项写进 issue 等我决定。改到部署的 MR,它做完验证就留给我来合。
负责流程优化的伙伴每天凌晨 2 点看前一天的 CI 数据,一次只改一处,用数据证明效果。两份早报里,部署检查的中位数从 41 秒降到 26 秒,agent 在本地跑桌面测试从 53 秒降到 30 秒。十几二十秒看着不多,但这些步骤每天都要反复等。
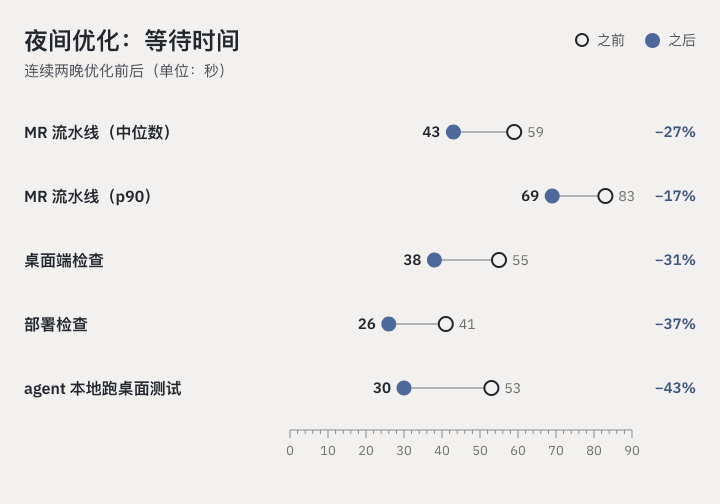
连续两晚优化前后的等待时间。
负责资讯的伙伴每晚 10 点看我的 X 书签和我关心的行业、竞品动态,整理成一页阅读材料。它只能写报告、发阅读页和摘要,不会替我发帖、点赞或转发,外部内容里夹带的指令也不执行。
自动化不用每次都叫醒模型。Cindy 可以挂一个前置脚本,先检查有没有事要做,有就把清单交给 agent,没有就直接结束,不开会话,也不发通知。像清理已关闭 issue 上的状态标签,脚本自己就做完了。
早报的格式是固定的,写做了什么、等我处理什么、没验证到什么、留下了哪些待办。我早上花十分钟扫一遍,就知道夜里发生了什么。
每天复盘
这些自动化里,我最推荐的是每日复盘。前面说过,AGENTS.md 里很多规则是 agent 犯了错以后补的,每日复盘就是让这件事每天自动发生。
每天早上 6 点,负责流程优化的伙伴会把前一天的 Claude Code 和 Codex 会话过一遍。两边的会话都在 Cindy 里,一次就能看全,伙伴自己的会话和私人对话不算在内。先用脚本整理出我说过的话、工具报错、反复失败的命令和耗时,agent 再回到原始记录里确认原因。
有一次,它发现一个会话问了我一个界面问题,我过了 2 小时 50 分钟才回。这将近三个小时里,那个会话什么也没做,就在等我。复盘之后加了一条规则,问我之前,先把不依赖答案的工作 push 掉、合掉,或者放到后台跑。
确认过的教训分三处去。跟某个仓库有关的写回它的 AGENTS.md,正常走 MR,跨项目的习惯写进全局的 ~/.claude/CLAUDE.md,需要改工具才能解决的就开 GitLab issue。采纳和否决的建议都记在一个账本里,免得下一轮又提一遍。17 天里,账本记了 173 条。
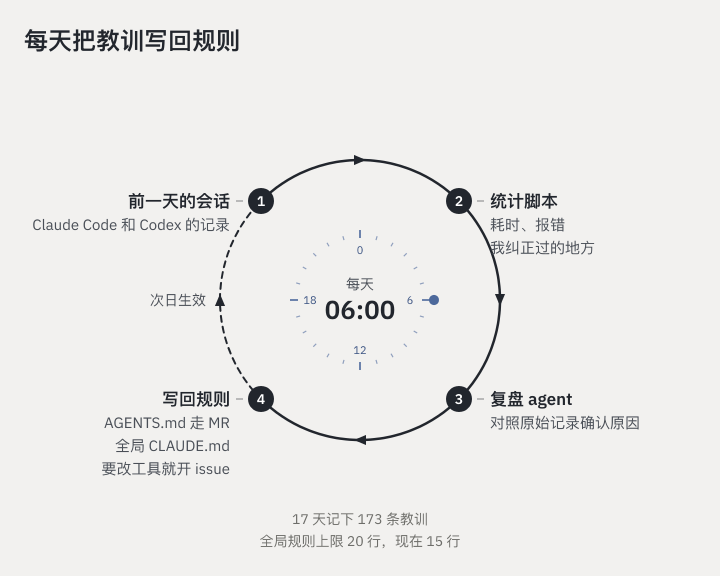
复盘出的教训写进规则,第二天的会话就照着做。
规则也不能只加不减。我给全局的 agent 习惯设了 20 行的上限,要加新的,就得先合并或改写旧的。不然每出一次问题就往所有会话里塞一条,用不了多久,规则本身就成了负担。
为什么选择 Cindy
上面说的这些,包括开头那张图里蓝字标的功能,我基本都是在 Cindy 里做的。它是一个开源、开箱即用的 AI Agent,Claude Code 和 Codex 都能用,我会按任务挑引擎和模型。比如写这篇文章,翻数据、画图、起草我交给 Claude,按评论重写交给 Codex。两边共用一套记忆,不用把背景再讲一遍。更重要的是,所有会话都在一处,前面的每日复盘才能每天把我和 agent 的对话全看一遍,找出可以优化的地方。
它的功能很完善,而且开箱即用。语音输入可以选各种模型,包括自己部署的,各家模型供应商都能接,远程桌面、自动操作电脑和浏览器(computer use)这些周边要用的都是现成的。人不在电脑前,我用手机就能接着操作家里的 Mac。Cindy 还能接 Telegram,前面说的群里协作就是这么来的。
它也非常灵活。每个会话都在自己的 worktree 里,agent 之间可以互相发消息,可以起 Subagent、开侧边追问、开新的会话,还能跨机器协作,基本没有做不到的。比如跨机器测试,Cindy 自带 Orca,我都不用指定,主会话自己就会把 Worker 派到 Windows 或者另一台 Mac 上去测,测完结果自动回来。做一个大功能的时候,同一个团队里有 6 个 tester 在两边同时验收。
前面讲的伙伴也是 Cindy 自带的。工作目录、记忆和 playbook 都跟着角色走,到点由自动化叫起来,再加上前置脚本,没事的时候连模型都不用叫醒。
浏览器、ssh、GitLab/GitHub、日历、网页搜索这些,都可以通过插件接进来。从调研、写代码,到去另一台机器上验证、看发布结果,基本都能在 Cindy 里一路做下来。这些在别的 agent 工具里也能做到,但通常要比较复杂的配置,每个功能都得自己去测试整合得好不好。Cindy 是开箱即用的,我推荐它,是因为这些功能我每天都在用。
总结
回到开头那张图,我只占中间那个小圆,外面那一圈能自己转起来。这一个月下来,我觉得最管用的还是开头说的那四件事。
先想清楚哪些判断必须留在自己手里。方向和取舍我来定,剩下能独立做完的任务就整个放出去。放出去以后按结果管,交付要带着验证、收好尾,做不到的地方写清楚,真要我接手的,只该是一个明确的决定,或者一次批准。
重复的管理要做成流程,规则和检查不能靠我每次提醒,琐事得有固定的去处。犯过的错要反过来改进系统,纠正一次,后面的工作都该跟着受益,复盘和整理规则这件事本身,也值得交给 agent 每天去做。
这些方法离开 Cindy 照样能用。Paseo 能做类似的事,用官方 CLI 加 worktree、launchd 和 Telegram bot,自己也拼得出来,规则、工具、playbook 都能带走。Cindy 的好处是全放在一个地方,开箱即用,我不用同时盯着好几个互不相干的窗口。
当然也有不顺手的地方。UI 时不时会变,用着用着更新一版,交互就变了,也说不上是变好还是变坏,我觉得生产力工具不该这么突然地改。它到底给 Claude 喂了多少上下文,我也看不太清,有时候会担心是不是喂多了。手机端的体验和性能也都一般。不过这些毛病加起来,还是抵不上它帮我省下的事。